乗算器シミュレーションと因数分解
2つの整数の乗算は加算を用いて実行できます. このセクションでは,全加算器を使って2つの4ビット整数の乗算器を設計します. 以下の図は,2つの4ビット整数 \(x_3x_2x_1x_0\) と \(y_3y_2y_1y_0\) を乗算して8ビット整数 \(z_7z_6z_5z_4z_3z_2z_1z_0\) を得る方法を示しています. この図では,\(p_{i,j}=x_iy_j\) (\(0\leq i,j\leq 3\)) であり,これらの部分積を加算して最終的な8ビットの結果を計算します.
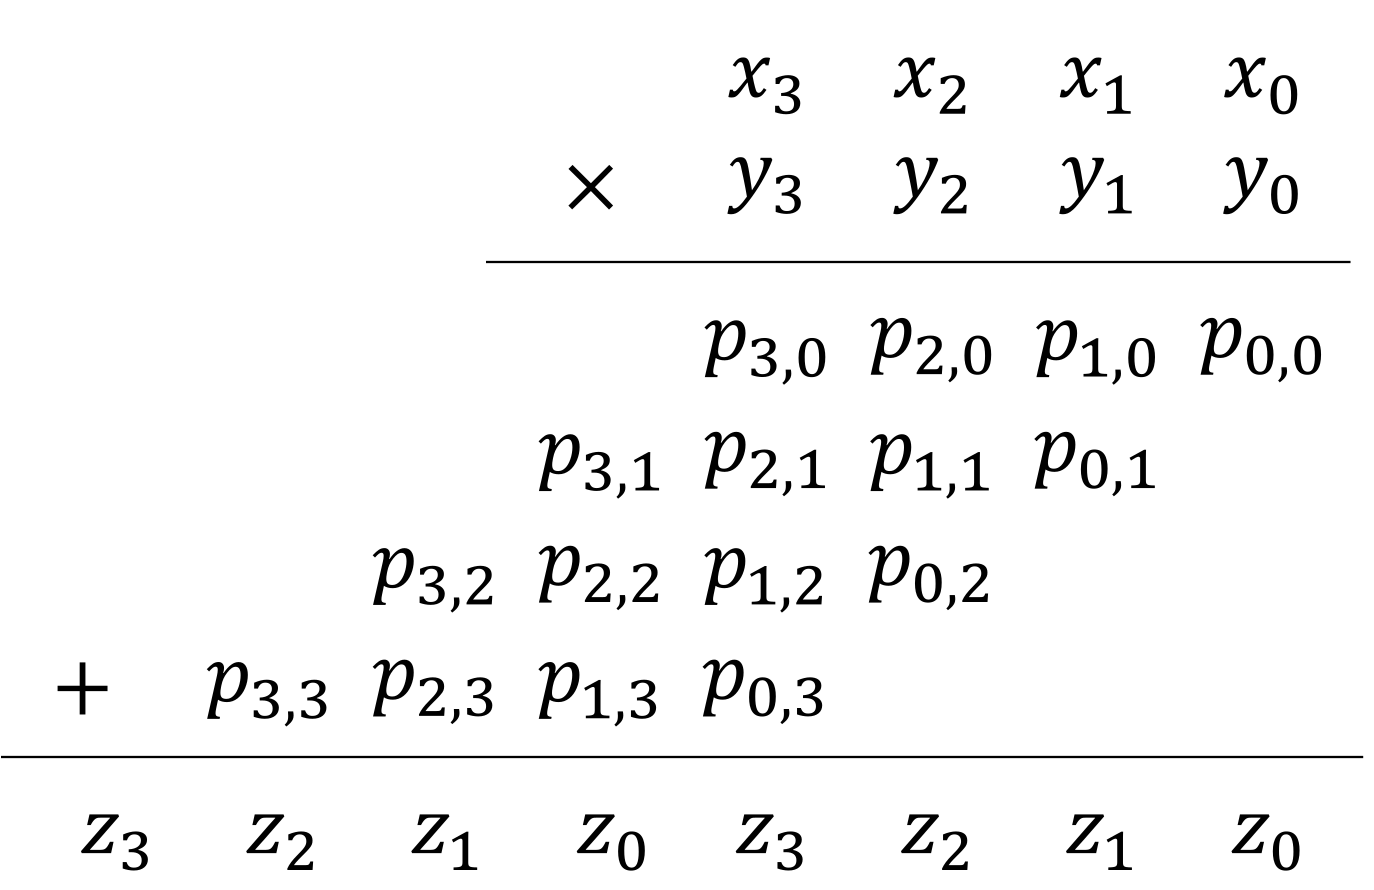
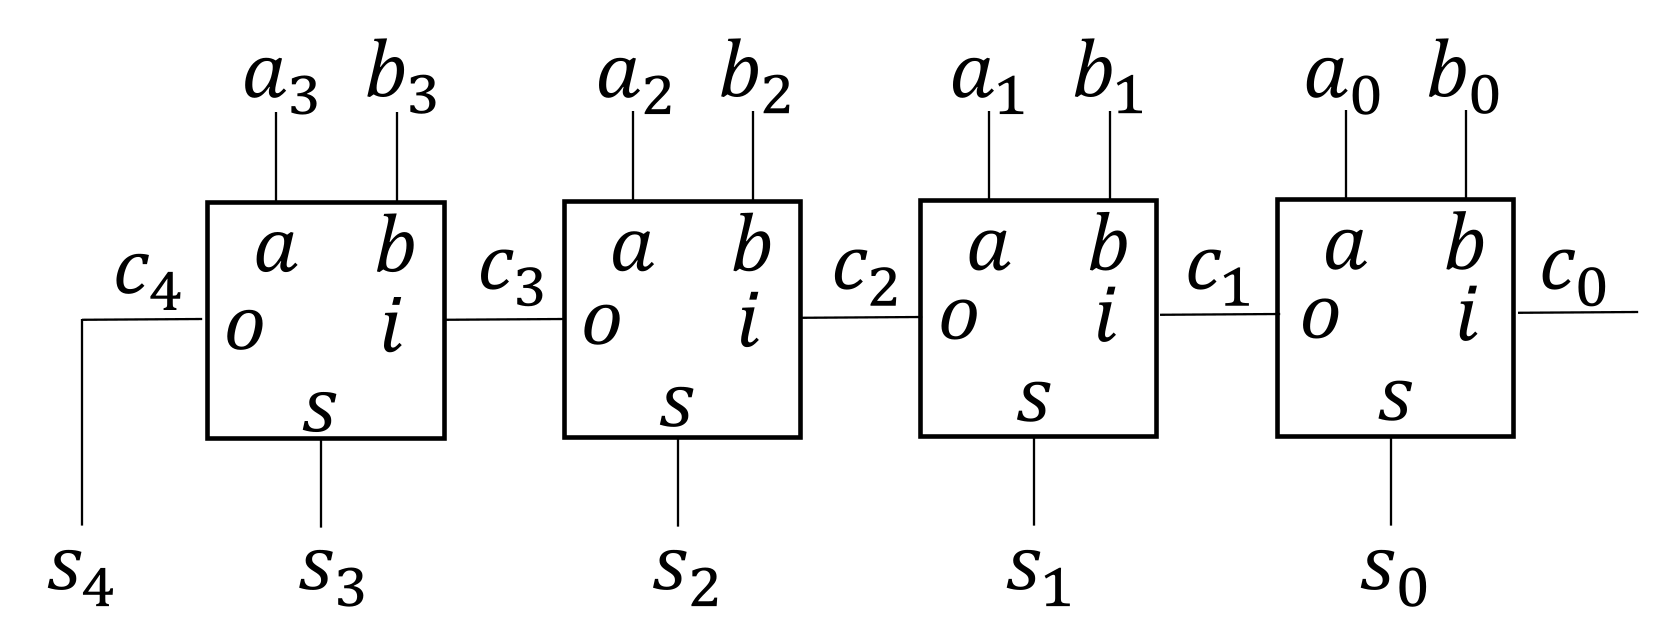
2つの4ビット整数 \(a_3a_2a_1a_0\) と \(b_3b_2b_1b_0\) の和を計算し,5ビットの和 \(z_4z_3z_2z_1z_0\) を出力する4ビットリプルキャリー加算器を使用します. これは,キャリーを伝搬する5ビットのキャリー線 \(c_4c_3c_2c_1c_0\) で接続された4つの全加算器で構成されます.
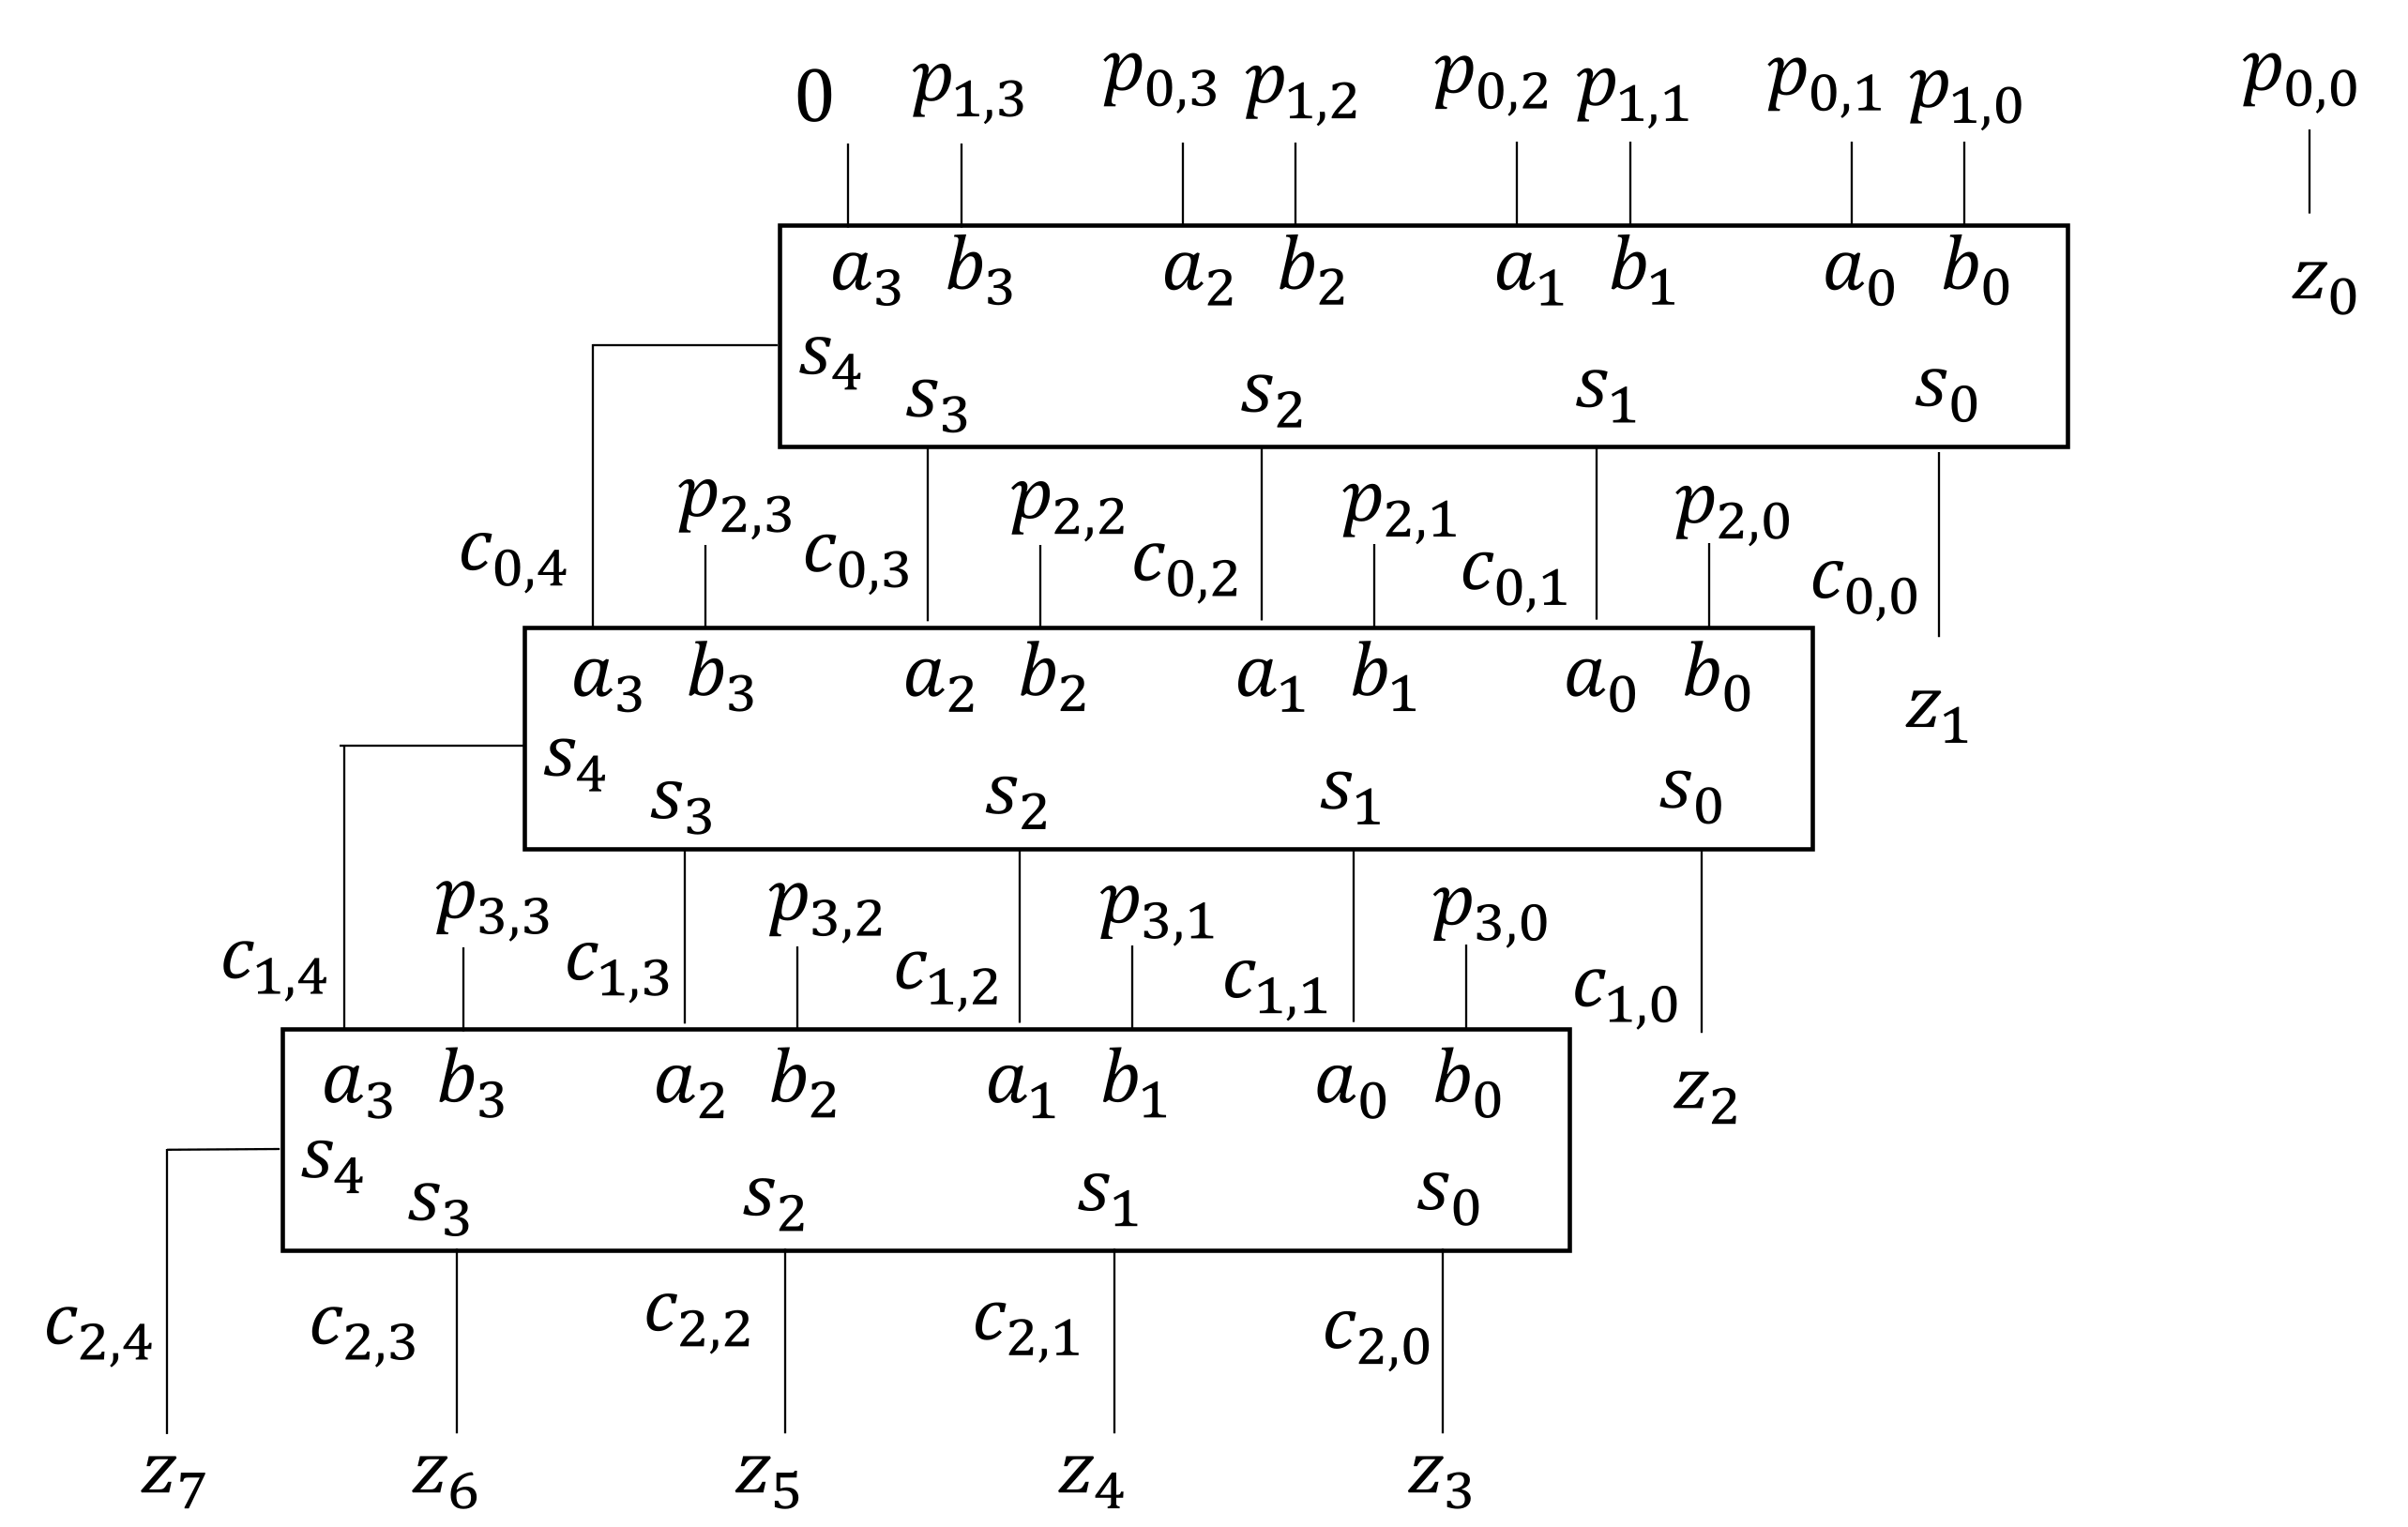
4ビット乗算器は3つの4ビット加算器を使って構築できます.
以下に示すように,中間の和ビットを伝搬するためにワイヤ \(c_{i,j}\) (\(0\leq i\leq 2, 0\leq j\leq 3\)) で接続されています:
乗算器のQUBO定式化
Nビット乗算器をシミュレートするためのQUBO定式化を示します.
そのために,全加算器,加算器,乗算器を構築する関数を実装します.
全加算器
以下のQUBO式は,3つの入力ビット a,b,i と2つの出力ビット(キャリー出力 o と和 s)を持つ全加算器をシミュレートします:
qbpp::Expr fa(const qbpp::Expr& a, const qbpp::Expr& b, const qbpp::Expr& i,
              const qbpp::Expr& o, const qbpp::Expr& s) {
  return (a + b + i) - (2 * o + s) == 0;
}
関数 fa は,全加算器の入力ビットと出力ビットの間の整合性を強制する式を返します.
加算器
配列 a,b,s が整数を表すとします.
a と b はそれぞれ N 個の要素を持ち N ビット整数を表し,s は N + 1 個の要素を持ち (N + 1) ビット整数を表すと仮定します.
以下の関数 adder は,a + b == s が成り立つとき,かつそのときに限り最小値0となるQUBO式を返します.
a,b,s は要素型が異なる配列(qbpp::Var,qbpp::Expr,qbpp::array による整数定数など)を受け取れるように,関数をテンプレートとして書きます:
template <typename A, typename B, typename S>
qbpp::Expr adder(const A& a, const B& b, const S& s) {
  auto N = a.size();
  auto c = qbpp::var("_c", N + 1);
  auto f = qbpp::toExpr(0);
  for (size_t j = 0; j < N; ++j) {
    f += fa(qbpp::toExpr(a[j]), qbpp::toExpr(b[j]), qbpp::toExpr(c[j]), qbpp::toExpr(c[j + 1]), qbpp::toExpr(s[j]));
  }
  f.replace({{qbpp::Var(c[0]), 0}, {qbpp::Var(c[N]), qbpp::toExpr(s[N])}});
  return f;
}
この関数では,c は N + 1 個の変数の配列であり,fa ブロックのキャリー出力信号とキャリー入力信号を接続して N ビットのリプルキャリー加算器を構成するために使用されます.
乗算器
配列 x,y,z が整数を表すとします.
x と y はそれぞれ N 個の要素を持ち,z は 2 * N 個の要素を持つと仮定します.
以下の関数 multiplier は,x * y == z が成り立つとき,かつそのときに限り最小値0となるQUBO式を返します.
adder と同じ理由で,呼び出し側が1次元の変数の配列,1次元の式の配列,あるいは1次元の整数定数の配列を自由に組み合わせて渡せるように,テンプレートとして書きます:
template <typename X, typename Y, typename Z>
qbpp::Expr multiplier(const X& x, const Y& y, const Z& z) {
  auto N = x.size();
  auto c = qbpp::var("c", N - 1, N + 1);

  auto f = qbpp::toExpr(0);

  for (size_t i = 0; i < N - 1; ++i) {
    auto b = qbpp::expr(N);
    for (size_t j = 0; j < N; ++j) {
      b[j] = qbpp::toExpr(x[i + 1]) * qbpp::toExpr(y[j]);
    }

    auto a = qbpp::expr(N);
    if (i == 0) {
      for (size_t j = 0; j < N - 1; ++j) {
        a[j] = qbpp::toExpr(x[0]) * qbpp::toExpr(y[j + 1]);
      }
      a[N - 1] = 0;
    } else {
      for (size_t j = 0; j < N; ++j) {
        a[j] = qbpp::toExpr(c[i - 1][j + 1]);
      }
    }

    auto s = qbpp::expr(N + 1);
    for (size_t j = 0; j < N + 1; ++j) {
      s[j] = qbpp::toExpr(c[i][j]);
    }
    f += adder(a, b, s);
  }
  f += qbpp::toExpr(z[0]) - qbpp::toExpr(x[0]) * qbpp::toExpr(y[0]) == 0;

  qbpp::MapList ml;
  for (size_t i = 0; i < N - 2; ++i) {
    ml.push_back({qbpp::Var(c[i][0]), qbpp::toExpr(z[i + 1])});
  }
  for (size_t i = 0; i < N + 1; ++i) {
    ml.push_back({qbpp::Var(c[N - 2][i]), qbpp::toExpr(z[N + i - 1])});
  }
  return f.replace(ml).simplify_as_binary();
}
この関数は,N-1 個の N ビット加算器を接続するために (N-1)x(N+1) の qbpp::Var オブジェクトの行列 c を使用します.
z の各ビットは c の1つの要素に対応するため,その対応関係が ml に定義され,replace() を使って置換が実行されます.
因数分解のためのHi-QUBOプログラム
関数 multiplier を使用して,合成整数を2つの因数に分解できます.
以下のプログラムは4ビット乗算器を構築します:
x: 4個のバイナリ変数,y: 4個のバイナリ変数,z: 定数配列{1, 1, 1, 1, 0, 0, 0, 1}(8ビット整数10001111すなわち143を表す).結果の式をfに格納します:
#include <qbpp/qbpp.hpp>
#include <qbpp/easy_solver.hpp>

qbpp::Expr fa(const qbpp::Expr& a, const qbpp::Expr& b, const qbpp::Expr& i,
              const qbpp::Expr& o, const qbpp::Expr& s) {
  return (a + b + i) - (2 * o + s) == 0;
}

template <typename A, typename B, typename S>
qbpp::Expr adder(const A& a, const B& b, const S& s) {
  auto N = a.size();
  auto c = qbpp::var("_c", N + 1);
  auto f = qbpp::toExpr(0);
  for (size_t j = 0; j < N; ++j) {
    f += fa(qbpp::toExpr(a[j]), qbpp::toExpr(b[j]), qbpp::toExpr(c[j]), qbpp::toExpr(c[j + 1]), qbpp::toExpr(s[j]));
  }
  return f.replace({{qbpp::Var(c[0]), 0}, {qbpp::Var(c[N]), qbpp::toExpr(s[N])}});
}

template <typename X, typename Y, typename Z>
qbpp::Expr multiplier(const X& x, const Y& y, const Z& z) {
  auto N = x.size();
  auto c = qbpp::var("c", N - 1, N + 1);

  auto f = qbpp::toExpr(0);

  for (size_t i = 0; i < N - 1; ++i) {
    auto b = qbpp::expr(N);
    for (size_t j = 0; j < N; ++j) {
      b[j] = qbpp::toExpr(x[i + 1]) * qbpp::toExpr(y[j]);
    }

    auto a = qbpp::expr(N);
    if (i == 0) {
      for (size_t j = 0; j < N - 1; ++j) {
        a[j] = qbpp::toExpr(x[0]) * qbpp::toExpr(y[j + 1]);
      }
      a[N - 1] = 0;
    } else {
      for (size_t j = 0; j < N; ++j) {
        a[j] = qbpp::toExpr(c[i - 1][j + 1]);
      }
    }

    auto s = qbpp::expr(N + 1);
    for (size_t j = 0; j < N + 1; ++j) {
      s[j] = qbpp::toExpr(c[i][j]);
    }
    f += adder(a, b, s);
  }
  f += qbpp::toExpr(z[0]) - qbpp::toExpr(x[0]) * qbpp::toExpr(y[0]) == 0;

  qbpp::MapList ml;
  for (size_t i = 0; i < N - 2; ++i) {
    ml.push_back({qbpp::Var(c[i][0]), qbpp::toExpr(z[i + 1])});
  }
  for (size_t i = 0; i < N + 1; ++i) {
    ml.push_back({qbpp::Var(c[N - 2][i]), qbpp::toExpr(z[N + i - 1])});
  }
  return f.replace(ml).simplify_as_binary();
}

int main() {
  auto x = qbpp::var("x", 4);
  auto y = qbpp::var("y", 4);
  auto z = qbpp::array({1, 1, 1, 1, 0, 0, 0, 1});
  auto f = multiplier(x, y, z).simplify_as_binary();

  auto solver = qbpp::EasySolver(f);
  auto sol = solver.search({{"target_energy", 0}});

  for (size_t i = x.size(); i > 0; --i) {
    std::cout << sol(x[i - 1]);
  }
  std::cout << " * ";
  for (size_t i = y.size(); i > 0; --i) {
    std::cout << sol(y[i - 1]);
  }
  std::cout << " = ";
  for (size_t i = z.size(); i > 0; --i) {
    std::cout << z[i - 1];
  }
  std::cout << std::endl;
}
Easy Solverが f に対して実行され,得られた解が sol に格納されます.
x と y の結果の値は以下のように出力されます:
1011 * 1101 = 10001111
この出力は \(11\times 13 = 143\) を示しており,因数分解の結果を実証しています.
2つの整数の乗算は加算を用いて実行できます. この節では,全加算器を使って2つの4ビット整数の乗算器を設計します. 以下の図は,2つの4ビット整数 \(x_3x_2x_1x_0\) と \(y_3y_2y_1y_0\) を乗算して8ビット整数 \(z_7z_6z_5z_4z_3z_2z_1z_0\) を得る方法を示しています. この図では,\(p_{i,j}=x_iy_j\) (\(0\leq i,j\leq 3\)) であり,これらの部分積を合計して最終的な8ビットの結果を計算します.
2つの4ビット整数 \(a_3a_2a_1a_0\) と \(b_3b_2b_1b_0\) の和を計算して5ビットの和 \(z_4z_3z_2z_1z_0\) を出力する4ビットリプルキャリー加算器を使用します. これは,キャリーを伝搬する5ビットのキャリー線 \(c_4c_3c_2c_1c_0\) で接続された4つの全加算器で構成されています.
4ビット乗算器は3つの4ビット加算器を使って構築できます.
以下に示すように,中間の和ビットを伝搬するためにワイヤ \(c_{i,j}\) (\(0\leq i\leq 2, 0\leq j\leq 3\)) で接続されています:
乗算器の QUBO 定式化
Nビット乗算器をシミュレートするための QUBO 定式化を示します.
そのために,全加算器,加算器,乗算器を構築する関数を実装します.
全加算器
以下の QUBO 式は,3つの入力ビット a,b,i と,2つの出力ビット: キャリーアウト o および和 s を持つ全加算器をシミュレートします:
def fa(a, b, i, o, s):
    return ((a + b + i) - (2 * o + s) == 0)
関数 fa は,全加算器の入力ビットと出力ビットの間の整合性を強制する式を返します.
expr == 0 は,expr == 0(すなわち全加算器が整合している状態)のときに限り最小値 0 を取る QUBO 式を返します.
加算器
リスト a,b,s が整数を表すとします.
a と b はそれぞれ N 要素を持ち Nビット整数を表し,s は N + 1 要素を持ち (N + 1)ビット整数を表します.
以下の関数 adder は,a + b == s が成り立つ場合に限り最小値が 0 となる QUBO 式を返します.
a,b,s は要素型が異なるコンテナ(バイナリ変数,式,整数定数など)であっても構いません.Python の動的型付けのおかげで型注釈は不要で,呼び出し側は手元にあるリストや配列をそのまま渡せます:
def adder(a, b, s):
    N = len(a)
    c = qbpp.var(shape=N + 1)
    f = 0
    for j in range(N):
        f += fa(a[j], b[j], c[j], c[j + 1], s[j])
    ml = {c[0]: 0, c[N]: s[N]}
    return qbpp.replace(f, ml)
この関数では,c は N + 1 個の変数のベクトルで,fa ブロックのキャリーアウトとキャリーインの信号を接続し,Nビットのリプルキャリー加算器を形成します.
qbpp.var(shape=N + 1) は自動命名された N + 1 個の新しいバイナリ変数配列を生成します(名前は内部で一意に振られるため,別々の加算器段から何度呼んでも衝突しません).
最後の qbpp.replace(f, ml) では,c[0] を 0(キャリー入力なし)に固定し,c[N] を s[N](和の最上位ビットが最終キャリー出力に相当)に束縛します.
乗算器
リスト x,y,z が整数を表すとします.
x と y はそれぞれ N 要素を持ち,z は 2 * N 要素を持つとします.
以下の関数 multiplier は,x * y == z が成り立つ場合に限り最小値が 0 となる QUBO 式を返します.
adder と同様,呼び出し側は変数配列・式リスト・整数定数を自由に組み合わせて渡せます.Python の動的型付けにより,混在した要素型は透過的に扱われます.
def multiplier(x, y, z):
    N = len(x)
    c = qbpp.var("c", shape=(N - 1, N + 1))

    f = 0

    for i in range(N - 1):
        b_vec = [x[i + 1] * y[j] for j in range(N)]

        if i == 0:
            a_vec = [x[0] * y[j + 1] for j in range(N - 1)] + [0]
        else:
            a_vec = [c[i - 1][j + 1] for j in range(N)]

        s_vec = [c[i][j] for j in range(N + 1)]
        f += adder(a_vec, b_vec, s_vec)

    f += (z[0] - x[0] * y[0] == 0)

    ml = {c[i][0]: z[i + 1] for i in range(N - 2)}
    ml.update({c[N - 2][i]: z[N + i - 1] for i in range(N + 1)})
    f = qbpp.replace(f, ml)
    f.simplify_as_binary()
    return f
この関数は (N-1)x(N+1) のバイナリ変数行列 c(qbpp.var("c", shape=(N - 1, N + 1)) で生成)を使って N-1 個の Nビット加算器を接続します.
各行 c[i] は i 番目の加算器段が出力する (N+1)ビットの和を保持し,その和は次の加算器段の a オペランドとして渡されるか,最終的な積 z のビットに対応付けられます.
z の各ビットは c の1つの要素に対応するため,その対応関係を辞書 ml で定義し,qbpp.replace(f, ml) で一括して置換を実行します.
追加項 z[0] - x[0] * y[0] == 0 は,どの加算器段からも生成されない積の最下位ビットを扱うためのものです.
最後の f.simplify_as_binary() の呼び出しは,f をバイナリ(0/1)ルールに従って in-place で簡約します(f を書き換え,戻り値は None です).
素因数分解の PyQBPP プログラム
関数 multiplier を使って,合成数を2つの因数に分解できます.
以下のプログラムは4ビット乗算器を構築します:
x: 4個のバイナリ変数,y: 4個のバイナリ変数,z: 定数リスト[1, 1, 1, 1, 0, 0, 0, 1](8ビット整数10001111すなわち143を表す).結果の式をfに格納します:
import pyqbpp as qbpp

def fa(a, b, i, o, s):
    return ((a + b + i) - (2 * o + s) == 0)

def adder(a, b, s):
    N = len(a)
    c = qbpp.var(shape=N + 1)
    f = 0
    for j in range(N):
        f += fa(a[j], b[j], c[j], c[j + 1], s[j])
    ml = {c[0]: 0, c[N]: s[N]}
    return qbpp.replace(f, ml)

def multiplier(x, y, z):
    N = len(x)
    c = qbpp.var("c", shape=(N - 1, N + 1))

    f = 0

    for i in range(N - 1):
        b_vec = [x[i + 1] * y[j] for j in range(N)]

        if i == 0:
            a_vec = [x[0] * y[j + 1] for j in range(N - 1)] + [0]
        else:
            a_vec = [c[i - 1][j + 1] for j in range(N)]

        s_vec = [c[i][j] for j in range(N + 1)]
        f += adder(a_vec, b_vec, s_vec)

    f += (z[0] - x[0] * y[0] == 0)

    ml = {c[i][0]: z[i + 1] for i in range(N - 2)}
    ml.update({c[N - 2][i]: z[N + i - 1] for i in range(N + 1)})
    f = qbpp.replace(f, ml)
    f.simplify_as_binary()
    return f

x = qbpp.var("x", shape=4)
y = qbpp.var("y", shape=4)
z = qbpp.array([1, 1, 1, 1, 0, 0, 0, 1])
f = multiplier(x, y, z)
f.simplify_as_binary()

solver = qbpp.EasySolver(f)
sol = solver.search(target_energy=0)

x_bits = "".join(str(sol(x[j])) for j in reversed(range(4)))
y_bits = "".join(str(sol(y[j])) for j in reversed(range(4)))
z_bits = "".join(str(z[j]) for j in reversed(range(8)))
print(f"{x_bits} * {y_bits} = {z_bits}")
Easy Solver が target_energy=0 を指定して f に対して実行され(これにより x * y == z が成り立つ基底状態を見つけた時点でソルバーが停止します),得られた解が sol に格納されます.
各変数の値は sol(x[j]) / sol(y[j]) を呼ぶと 0/1 の割当として取得できます.
これらのビットを最上位ビットから並ぶよう逆順に連結して,以下のバイナリ表記を出力します:
1011 * 1101 = 10001111
この出力は \(11\times 13 = 143\) を示しており,素因数分解の結果を実証しています.