加算器シミュレーション
全加算器とリプルキャリー加算器
全加算器は3つの入力ビット \(a\),\(b\),\(i\)(キャリー入力)と, \(o\)(キャリー出力)および \(s\)(和)を持ちます. 3つの入力ビットの和は,これら2つの出力ビットを使って表されます.
リプルキャリー加算器は,以下に示すように複数の全加算器をカスケード接続することで,2つの多ビット整数の和を計算します:
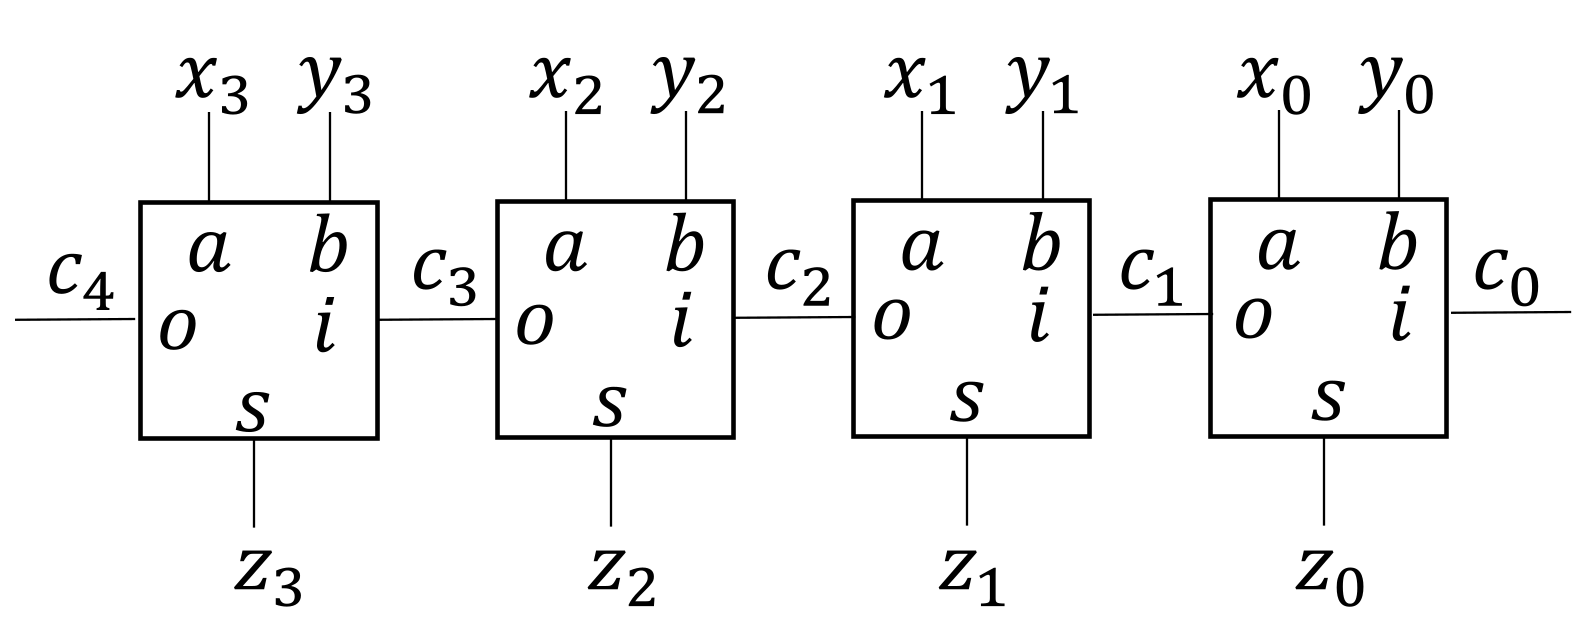
このリプルキャリー加算器は,4つの全加算器を使って2つの4ビット整数 \(x_3x_2x_1x_0\) と \(y_3y_2y_1y_0\) の和を計算し,4ビットの和 \(z_3z_2z_1z_0\) を出力します. 対応する5ビットのキャリー信号 \(c_4c_3c_2c_1c_0\) も示されています.
全加算器のQUBO定式化
全加算器は以下の式を用いて定式化できます:
この式は,5つの変数が有効な全加算器の動作と整合する値を取るとき,かつそのときに限り,最小値0を達成します. 以下のHi-QUBOプログラムは,Exhaustive Solverを使ってこの定式化を検証します:
#include <qbpp/qbpp.hpp>
#include <qbpp/exhaustive_solver.hpp>

int main() {
  auto a = qbpp::var("a");
  auto b = qbpp::var("b");
  auto i = qbpp::var("i");
  auto o = qbpp::var("o");
  auto s = qbpp::var("s");
  auto fa = (a + b + i) - (2 * o + s) == 0;
  fa.simplify_as_binary();
  auto solver = qbpp::ExhaustiveSolver(fa);
  auto sol = solver.search({{"best_energy_sols", 0}});
  for (size_t k = 0; k < sol.size(); ++k) {
    std::cout << "(" << k << ") " << sol.sols[k] << std::endl;
  }
}
このQUBOプログラムでは,制約 \(fa(a,b,i,o,s)\) は等号演算子 == を使って実装されており,直感的に制約 \(a+b+i=2o+s\) を表しています.
プログラムは以下の出力を生成し,式が全加算器を正しくモデル化していることを確認します:
(0) 0:{{a,0},{b,0},{i,0},{o,0},{s,0}}
(1) 0:{{a,1},{b,1},{i,0},{o,1},{s,0}}
(2) 0:{{a,1},{b,0},{i,1},{o,1},{s,0}}
(3) 0:{{a,0},{b,1},{i,1},{o,1},{s,0}}
(4) 0:{{a,1},{b,0},{i,0},{o,0},{s,1}}
(5) 0:{{a,0},{b,1},{i,0},{o,0},{s,1}}
(6) 0:{{a,0},{b,0},{i,1},{o,0},{s,1}}
(7) 0:{{a,1},{b,1},{i,1},{o,1},{s,1}}
一部のビットを固定すると,残りのビットの有効な値を導出できます.
例えば,qbpp::replace() 関数で3つの入力ビットを固定します(グローバル関数を使うことで制約式のメタデータが保たれます):
  auto fa2 = qbpp::replace(fa, {{a, 1}, {b, 1}, {i, 0}});
  fa2.simplify_as_binary();
  auto solver2 = qbpp::ExhaustiveSolver(fa2);
  auto sol2 = solver2.search({{"best_energy_sols", 0}});
  for (size_t k = 0; k < sol2.size(); ++k) {
    std::cout << "(" << k << ") " << sol2.sols[k] << std::endl;
  }
この場合,qbpp::ExhaustiveSolver(fa2) で解を探索します.
プログラムは以下の出力を生成します:
(0) 0:{{o,1},{s,0}}
逆に,2つの出力ビットを固定した場合:
  auto fa2 = qbpp::replace(fa, {{o, 1}, {s, 0}});
  fa2.simplify_as_binary();
  auto solver2 = qbpp::ExhaustiveSolver(fa2);
  auto sol2 = solver2.search({{"best_energy_sols", 0}});
  for (size_t k = 0; k < sol2.size(); ++k) {
    std::cout << "(" << k << ") " << sol2.sols[k] << std::endl;
  }
プログラムは入力ビットのすべての有効な組み合わせを出力します:
(0) 0:{{a,1},{b,1},{i,0}}
(1) 0:{{a,1},{b,0},{i,1}}
(2) 0:{{a,0},{b,1},{i,1}}
複数の全加算器を用いたリプルキャリー加算器のシミュレーション
全加算器のQUBO式を使って,リプルキャリー加算器をシミュレートするQUBO式を構築できます. 以下のHi-QUBOプログラムは,4つの全加算器を組み合わせて4ビット加算器をシミュレートするQUBO式を作成します:
#include <qbpp/qbpp.hpp>
#include <qbpp/exhaustive_solver.hpp>

int main() {
  auto a = qbpp::var("a");
  auto b = qbpp::var("b");
  auto i = qbpp::var("i");
  auto o = qbpp::var("o");
  auto s = qbpp::var("s");
  auto fa = (a + b + i) - (2 * o + s) == 0;

  auto x = qbpp::var("x", 4);
  auto y = qbpp::var("y", 4);
  auto c = qbpp::var("c", 5);
  auto z = qbpp::var("s", 4);

  auto fa0 = qbpp::replace(fa, {{a, x[0]}, {b, y[0]}, {i, c[0]}, {o, c[1]}, {s, z[0]}});
  auto fa1 = qbpp::replace(fa, {{a, x[1]}, {b, y[1]}, {i, c[1]}, {o, c[2]}, {s, z[1]}});
  auto fa2 = qbpp::replace(fa, {{a, x[2]}, {b, y[2]}, {i, c[2]}, {o, c[3]}, {s, z[2]}});
  auto fa3 = qbpp::replace(fa, {{a, x[3]}, {b, y[3]}, {i, c[3]}, {o, c[4]}, {s, z[3]}});
  auto adder = fa0 + fa1 + fa2 + fa3;
  adder.simplify_as_binary();

  auto solver = qbpp::ExhaustiveSolver(adder);
  auto sol = solver.search({{"best_energy_sols", 0}});
  for (size_t k = 0; k < sol.size(); ++k) {
    std::cout << "(" << k << ") " << sol.sols[k] << std::endl;
  }
}
このHi-QUBOプログラムでは,全加算器を表す4つの qbpp::Expr オブジェクトが replace() 関数を使って作成され,単一の式 adder にまとめられます.
次にExhaustive Solverがすべての最適解を列挙します.
このプログラムは512個の有効な解を生成し,4ビット加算器のすべての可能な入力の組み合わせに対応します:
(0) 0:{{x[0],0},{x[1],0},{x[2],0},{x[3],0},{y[0],0},{y[1],0},{y[2],0},{y[3],0},{c[0],0},{c[1],0},{c[2],0},{c[3],0},{c[4],0},{s[0],0},{s[1],0},{s[2],0},{s[3],0}}
(1) 0:{{x[0],0},{x[1],0},{x[2],0},{x[3],1},{y[0],0},{y[1],0},{y[2],0},{y[3],1},{c[0],0},{c[1],0},{c[2],0},{c[3],0},{c[4],1},{s[0],0},{s[1],0},{s[2],0},{s[3],0}}
(2) 0:{{x[0],0},{x[1],0},{x[2],1},{x[3],1},{y[0],0},{y[1],0},{y[2],1},{y[3],0},{c[0],0},{c[1],0},{c[2],0},{c[3],1},{c[4],1},{s[0],0},{s[1],0},{s[2],0},{s[3],0}}
(3) 0:{{x[0],0},{x[1],0},{x[2],1},{x[3],0},{y[0],0},{y[1],0},{y[2],1},{y[3],1},{c[0],0},{c[1],0},{c[2],0},{c[3],1},{c[4],1},{s[0],0},{s[1],0},{s[2],0},{s[3],0}}

...

(510) 0:{{x[0],1},{x[1],1},{x[2],1},{x[3],0},{y[0],1},{y[1],1},{y[2],1},{y[3],0},{c[0],1},{c[1],1},{c[2],1},{c[3],1},{c[4],0},{s[0],1},{s[1],1},{s[2],1},{s[3],1}}
(511) 0:{{x[0],1},{x[1],1},{x[2],1},{x[3],1},{y[0],1},{y[1],1},{y[2],1},{y[3],1},{c[0],1},{c[1],1},{c[2],1},{c[3],1},{c[4],1},{s[0],1},{s[1],1},{s[2],1},{s[3],1}}
あるいは,C++関数 fa を定義して,全加算器の制約をより簡潔で読みやすい形式で構築することもできます:
#include <qbpp/qbpp.hpp>
#include <qbpp/exhaustive_solver.hpp>

qbpp::Expr fa(qbpp::Var a, qbpp::Var b, qbpp::Var i, qbpp::Var o, qbpp::Var s) {
  return (a + b + i) - (2 * o + s) == 0;
}

int main() {
  auto x = qbpp::var("x", 4);
  auto y = qbpp::var("y", 4);
  auto c = qbpp::var("c", 5);
  auto z = qbpp::var("s", 4);
  auto fa0 = fa(x[0], y[0], c[0], c[1], z[0]);
  auto fa1 = fa(x[1], y[1], c[1], c[2], z[1]);
  auto fa2 = fa(x[2], y[2], c[2], c[3], z[2]);
  auto fa3 = fa(x[3], y[3], c[3], c[4], z[3]);
  auto adder = fa0 + fa1 + fa2 + fa3;
  adder.simplify_as_binary();
  auto solver = qbpp::ExhaustiveSolver(adder);
  auto sol = solver.search({{"best_energy_sols", 0}});
  for (size_t k = 0; k < sol.size(); ++k) {
    std::cout << "(" << k << ") " << sol.sols[k] << std::endl;
  }
}
このプログラムは前の実装と同じ512個の最適解を生成します.
一部のバイナリ変数を固定すると,残りの変数の有効な値をExhaustive Solverで導出できます.
例えば,以下の qbpp::MapList オブジェクト ml はキャリー入力,キャリー出力,および和のビットを固定します:
  qbpp::MapList ml = {{c[4], 1}, {c[0], 0}, {z[3], 1},
                      {z[2], 1}, {z[1], 0}, {z[0], 1}};
  adder.replace(ml);
  adder.simplify_as_binary();
  auto solver2 = qbpp::ExhaustiveSolver(adder);
  auto sol2 = solver2.search({{"best_energy_sols", 0}});
  for (size_t k = 0; k < sol2.size(); ++k) {
    std::cout << "(" << k << ") " << sol2.sols[k] << std::endl;
  }
結果のプログラムは以下の出力を生成します:
(0) 0:{{x[0],1},{x[1],1},{x[2],1},{x[3],1},{y[0],0},{y[1],1},{y[2],1},{y[3],1},{c[1],0},{c[2],1},{c[3],1}}
(1) 0:{{x[0],0},{x[1],1},{x[2],1},{x[3],1},{y[0],1},{y[1],1},{y[2],1},{y[3],1},{c[1],0},{c[2],1},{c[3],1}}
全加算器とリプルキャリー加算器
全加算器は3つの入力ビット \(a\),\(b\),\(i\)(キャリー入力)と, \(o\)(キャリー出力)および \(s\)(和)を持ちます. 3つの入力ビットの和は,これら2つの出力ビットを使って表されます.
リプルキャリー加算器は,以下に示すように複数の全加算器をカスケード接続することで,2つの多ビット整数の和を計算します:
このリプルキャリー加算器は,4つの全加算器を使って2つの4ビット整数 \(x_3x_2x_1x_0\) と \(y_3y_2y_1y_0\) の和を計算し,4ビットの和 \(z_3z_2z_1z_0\) を出力します. 対応する5ビットのキャリー信号 \(c_4c_3c_2c_1c_0\) も示されています.
全加算器の QUBO 定式化
全加算器は以下の式を用いて定式化できます:
この式は,5つの変数が有効な全加算器の動作と整合する値を取るとき,かつそのときに限り,最小値 0 を達成します. 以下の PyQBPP プログラムは,Exhaustive Solver を使ってこの定式化を検証します:
import pyqbpp as qbpp

a = qbpp.var("a")
b = qbpp.var("b")
i = qbpp.var("i")
o = qbpp.var("o")
s = qbpp.var("s")
fa = ((a + b + i) - (2 * o + s) == 0)
fa.simplify_as_binary()
solver = qbpp.ExhaustiveSolver(fa)
result = solver.search(best_energy_sols=0)
for idx, sol in enumerate(result.sols):
    vals = {v: sol(v) for v in [a, b, i, o, s]}
    print(f"({idx}) {sol.energy}: a={vals[a]}, b={vals[b]}, i={vals[i]}, o={vals[o]}, s={vals[s]}")
この PyQBPP プログラムでは,制約 \(fa(a,b,i,o,s)\) は ... == 0 を使って実装されており,直感的に制約 \(a+b+i=2o+s\) を表しています.
best_energy_sols=0 を指定することで,最小(最良)エネルギーを達成するすべての解を個数制限なしで収集します.
プログラムは以下の出力を生成し,式が全加算器を正しくモデル化していることを確認します:
(0) 0: a=0, b=0, i=0, o=0, s=0
(1) 0: a=1, b=1, i=0, o=1, s=0
(2) 0: a=1, b=0, i=1, o=1, s=0
(3) 0: a=0, b=1, i=1, o=1, s=0
(4) 0: a=1, b=0, i=0, o=0, s=1
(5) 0: a=0, b=1, i=0, o=0, s=1
(6) 0: a=0, b=0, i=1, o=0, s=1
(7) 0: a=1, b=1, i=1, o=1, s=1
各行は,インデックス,エネルギー(有効な割り当てでは 0),およびすべての変数の値を示します.全加算器の真理値表の8行すべてが最適解として現れます.
一部のビットを固定すると,残りのビットの有効な値を導出できます.
例えば,qbpp.replace() 関数で3つの入力ビットを固定します:
fa2 = qbpp.replace(fa, {a: 1, b: 1, i: 0})
fa2.simplify_as_binary()
solver2 = qbpp.ExhaustiveSolver(fa2)
result2 = solver2.search(best_energy_sols=0)
for idx, sol in enumerate(result2.sols):
    print(f"({idx}) {sol.energy}: o={sol(o)}, s={sol(s)}")
qbpp.replace(expr, mapping) は,辞書内の各キーを対応する値(定数または別の変数や式)で置換した新しい式を返します.元の fa は変更されません.この場合,qbpp.ExhaustiveSolver(fa2) で解を探索します.
プログラムは以下の出力を生成します:
(0) 0: o=1, s=0
これは \(1 + 1 + 0\) に対する期待されるキャリー出力と和です.
逆に,2つの出力ビットを固定した場合:
fa2 = qbpp.replace(fa, {o: 1, s: 0})
fa2.simplify_as_binary()
solver2 = qbpp.ExhaustiveSolver(fa2)
result2 = solver2.search(best_energy_sols=0)
for idx, sol in enumerate(result2.sols):
    print(f"({idx}) {sol.energy}: a={sol(a)}, b={sol(b)}, i={sol(i)}")
プログラムは入力ビットのすべての有効な組み合わせを出力します:
(0) 0: a=1, b=1, i=0
(1) 0: a=1, b=0, i=1
(2) 0: a=0, b=1, i=1
複数の全加算器を用いたリプルキャリー加算器のシミュレーション
全加算器の QUBO 式を使って,リプルキャリー加算器をシミュレートする QUBO 式を構築できます. 以下の PyQBPP プログラムは,4つの全加算器を組み合わせて4ビット加算器をシミュレートする QUBO 式を作成します:
import pyqbpp as qbpp

a = qbpp.var("a")
b = qbpp.var("b")
i = qbpp.var("i")
o = qbpp.var("o")
s = qbpp.var("s")
fa = ((a + b + i) - (2 * o + s) == 0)

x = qbpp.var("x", shape=4)
y = qbpp.var("y", shape=4)
c = qbpp.var("c", shape=5)
z = qbpp.var("z", shape=4)

fa0 = qbpp.replace(fa, {a: x[0], b: y[0], i: c[0], o: c[1], s: z[0]})
fa1 = qbpp.replace(fa, {a: x[1], b: y[1], i: c[1], o: c[2], s: z[1]})
fa2 = qbpp.replace(fa, {a: x[2], b: y[2], i: c[2], o: c[3], s: z[2]})
fa3 = qbpp.replace(fa, {a: x[3], b: y[3], i: c[3], o: c[4], s: z[3]})

adder = fa0 + fa1 + fa2 + fa3
adder.simplify_as_binary()

solver = qbpp.ExhaustiveSolver(adder)
result = solver.search(best_energy_sols=0)
for idx, sol in enumerate(result.sols):
    print(f"({idx}) {sol.energy}: x={sol(x)}, y={sol(y)}, c={sol(c)}, z={sol(z)}")
この PyQBPP プログラムでは,全加算器を表す4つの式が replace() 関数を使って作成され,単一の式 adder にまとめられます.
ここで qbpp.var("x", shape=4) は4つのバイナリ変数 x[0], x[1], x[2], x[3] の array を返し,qbpp.replace() に渡す辞書で各スカラのプレースホルダ(a,b,i,o,s)を対応する配列要素に置換します.
次に Exhaustive Solver がすべての最適解を列挙します.sol(x),sol(y),sol(c),sol(z) は配列に割り当てられた値を Python のリストとして返します.
このプログラムは512個の有効な解を生成し,4ビット加算器のすべての可能な入力の組み合わせに対応します:
(0) 0:{{x[0],0},{x[1],0},{x[2],0},{x[3],0},{y[0],0},{y[1],0},{y[2],0},{y[3],0},{c[0],0},{c[1],0},{c[2],0},{c[3],0},{c[4],0},{s[0],0},{s[1],0},{s[2],0},{s[3],0}}
(1) 0:{{x[0],0},{x[1],0},{x[2],0},{x[3],1},{y[0],0},{y[1],0},{y[2],0},{y[3],1},{c[0],0},{c[1],0},{c[2],0},{c[3],0},{c[4],1},{s[0],0},{s[1],0},{s[2],0},{s[3],0}}
(2) 0:{{x[0],0},{x[1],0},{x[2],1},{x[3],1},{y[0],0},{y[1],0},{y[2],1},{y[3],0},{c[0],0},{c[1],0},{c[2],0},{c[3],1},{c[4],1},{s[0],0},{s[1],0},{s[2],0},{s[3],0}}
(3) 0:{{x[0],0},{x[1],0},{x[2],1},{x[3],0},{y[0],0},{y[1],0},{y[2],1},{y[3],1},{c[0],0},{c[1],0},{c[2],0},{c[3],1},{c[4],1},{s[0],0},{s[1],0},{s[2],0},{s[3],0}}

...

(510) 0:{{x[0],1},{x[1],1},{x[2],1},{x[3],0},{y[0],1},{y[1],1},{y[2],1},{y[3],0},{c[0],1},{c[1],1},{c[2],1},{c[3],1},{c[4],0},{s[0],1},{s[1],1},{s[2],1},{s[3],1}}
(511) 0:{{x[0],1},{x[1],1},{x[2],1},{x[3],1},{y[0],1},{y[1],1},{y[2],1},{y[3],1},{c[0],1},{c[1],1},{c[2],1},{c[3],1},{c[4],1},{s[0],1},{s[1],1},{s[2],1},{s[3],1}}
これら512個の解は,4ビット入力 x,y,および初期キャリー入力 c[0] のすべての組み合わせ(24 x 24 x 2 = 512)に対応します.
あるいは,Python 関数 fa を定義して,全加算器の制約をより簡潔で読みやすい形式で構築することもできます:
import pyqbpp as qbpp

def fa(a, b, i, o, s):
    return ((a + b + i) - (2 * o + s) == 0)

x = qbpp.var("x", shape=4)
y = qbpp.var("y", shape=4)
c = qbpp.var("c", shape=5)
z = qbpp.var("z", shape=4)

fa0 = fa(x[0], y[0], c[0], c[1], z[0])
fa1 = fa(x[1], y[1], c[1], c[2], z[1])
fa2 = fa(x[2], y[2], c[2], c[3], z[2])
fa3 = fa(x[3], y[3], c[3], c[4], z[3])
adder = fa0 + fa1 + fa2 + fa3
adder.simplify_as_binary()

solver = qbpp.ExhaustiveSolver(adder)
result = solver.search(best_energy_sols=0)
for idx, sol in enumerate(result.sols):
    print(f"({idx}) {sol.energy}: x={sol(x)}, y={sol(y)}, c={sol(c)}, z={sol(z)}")
このプログラムは前の実装と同じ512個の最適解を生成します.
一部のバイナリ変数を固定すると,残りの変数の有効な値を Exhaustive Solver で導出できます.
例えば,以下の辞書 ml はキャリー入力,キャリー出力,および和のビットを固定します:
ml = {c[4]: 1, c[0]: 0, z[3]: 1,
      z[2]: 1, z[1]: 0, z[0]: 1}
adder = qbpp.replace(adder, ml)
adder.simplify_as_binary()
solver2 = qbpp.ExhaustiveSolver(adder)
result2 = solver2.search(best_energy_sols=0)
for idx, sol in enumerate(result2.sols):
    print(f"({idx}) {sol.energy}: x={sol(x)}, y={sol(y)}, c={sol(c)}, z={sol(z)}")
これは4ビットの和 z = 1101(2進数,最下位ビットから: z[0]=1, z[1]=0, z[2]=1, z[3]=1)と,キャリー入力 c[0]=0,キャリー出力 c[4]=1 を割り当てます.すなわち,初期キャリーなしで和 \(x + y = 11101_{2} = 29\) を表します.
結果のプログラムは以下の出力を生成します:
(0) 0:{{x[0],1},{x[1],1},{x[2],1},{x[3],1},{y[0],0},{y[1],1},{y[2],1},{y[3],1},{c[1],0},{c[2],1},{c[3],1}}
(1) 0:{{x[0],0},{x[1],1},{x[2],1},{x[3],1},{y[0],1},{y[1],1},{y[2],1},{y[3],1},{c[1],0},{c[2],1},{c[3],1}}
どちらの解も \(14 + 15 = 29\) と \(15 + 14 = 29\) に対応しており,指定されたキャリーパターンで4ビットの和 1101 を得る2通りの方法です.
出力で z と固定したキャリービットが 0 と表示される点に注意してください.replace() は固定した変数をモデルから消去するため,sol(z) / sol(c[4]) は割り当てた 1101 / 1 ではなくデフォルト値を返します.実際に解かれている変数は x と y です.